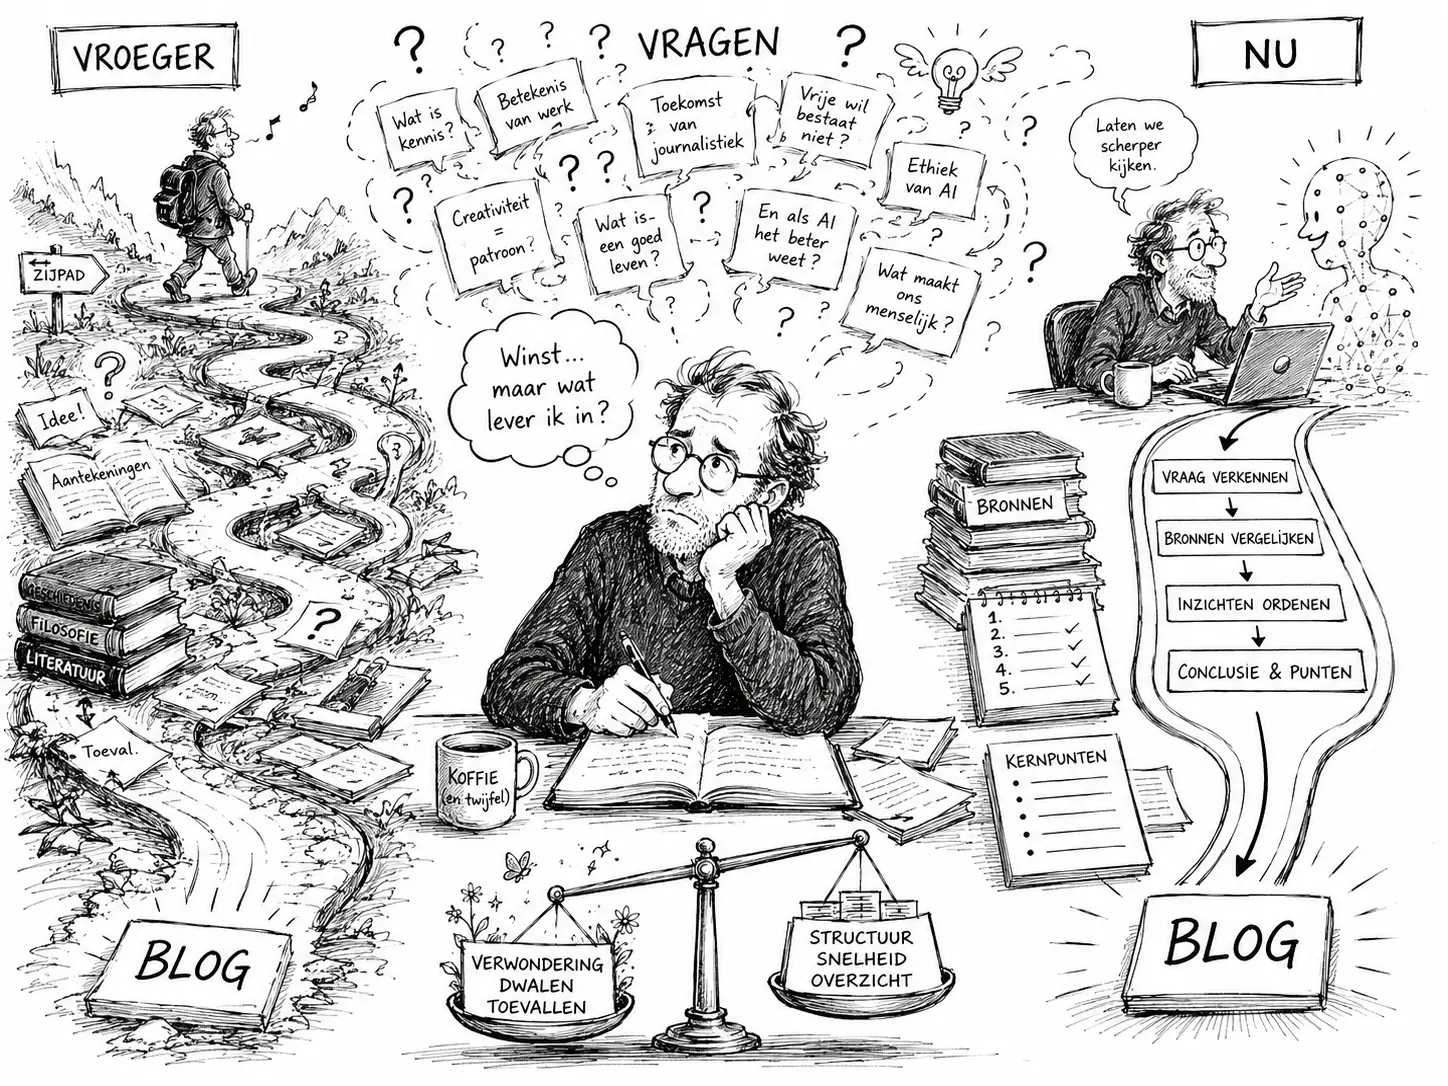
782 StoryScope en ChatGPT 5.6 (1e deel: opzet)
Tja, die wetenschapspraktijk toch. Ik loop tegen een paper aan waarin de wetenschappers onderzoeken in hoeverre AI-gegenereerde teksten afwijken van menselijke teksten. Ze hebben daarvoor een tool ‘StoryScope’ ontwikkeld en leiden een hele batterij aan teksten van bepaalde grootte door een ‘pijplijn’ die toetst op allerlei criteria. Je kunt dat paper makkelijk zelf vinden en het zal je opvallen hoezeer dat in het traditionele patroon valt van wat wij denken dat wetenschap moet zijn (strak format, bronnen, allerlei codes en nummeringen, voorspelbare opzet en indeling etc maar vooral niet uitnodigend om te lezen, boodschap is: hoho, dit doe je niet even zelf op een achternamiddag en zeker niet als gewone sterveling). Ik heb dat paper onderaan laten samenvatten voor je/ons gemak, want dat helemaal zelf lezen, dacht het niet.
Eigenlijk hoef ik ook helemaal niet precies te weten hoe ze dat in elkaar hebben gestoken. We kunnen met gezond verstand al een paar conclusies trekken en vragen stellen. Conclusie 1 lijkt me: blijkbaar lijken die AI-teksten verdomd veel op menselijke teksten want anders hoef je niet zo moeilijk te doen. Conclusie 2: ik durf er iets om te verwedden dat ze om de tool te ontwikkelen en al die teksten op te halen en door de pijplijn te krijgen zelf ook AI hebben ingezet. Mijn belangrijkste vragen voor nu: 1 = waar is die tool, ik wil er zelf ook gebruik van maken, even testen hoe het werkt, wat eigen spul erin gooien. Nou dat is ondanks de wetenschappelijke transparantie nog niet zo makkelijk, het kan vermoedelijk wel maar kost mij te veel stappen voor dit geintje, ergo kom ik op het idee een ‘Rudy-lookalike ‘StoryScope’ te maken en laat ik dan meteen de nieuwste gisteren gelanceerde versie van ChatGPT 5.6 gebruiken.
Daarover gaat deze blog en de volgende, hier in dit deel de methode en achtergrond, hierna in het volgende deel de uitkomsten van de test op basis van eigen schrijfsels. Vraag 2 = hoe tijdelijk zijn dit soort onderzoeken en conclusies? Immers, AI leert snel en je kunt snappen dat onvolmaaktheden en afwijkingen zomaar kunnen worden geïncorporeerd in volgende versies van AI afhankelijk van je wens en prompt. Het lijkt mij op voorhand een vrij hopeloze en nutteloze (maar daarmee niet minder interessante, want de soort en mate van afwijkingen boeien me) exercitie die hooguit een momentopname is.
https://jenna-russell.github.io/assets/pdf/storyscope.pdf hier wordt gesproken over een tool waarmee je kunt checken of iets wel/niet door AI is gemaakt. Mijn eerste vraag is of ik zelf die tool kan inzetten en gebruiken bij wijze van experiment? Zoniet, kunnen we conform die opzet en filosofie zelf zoiets opzetten/maken?
Ik stel voor een eigen rudy-storyscope te maken. Het gaat me niet om de wetenschappelijke diepgang. Je kijkt naar de kenmerken uit de oorspronkelijke teksten waar ze op meten (lineariteit etc) en bouwt dat zelf in in onze eigen versie. Als menselijke teksten gebruiken we bijvoorbeeld de blogs uit slimmefinanciering.nl en blokjesenpijltjes.nl, vervolgens zetten we dat af tegen rudymentair.nl en analyseren volgens ons mini-model de verschillen.
Rudy StoryScope 0.1
De drie corpora
| Corpus | Functie |
|---|---|
| Slimmefinanciering.nl | Oud menselijk referentieprofiel, waarschijnlijk meer economisch en vakinhoudelijk |
| Blokjesenpijltjes.nl | Tweede menselijk referentieprofiel, mogelijk persoonlijker, associatiever of beschouwender |
| Rudymentair.nl | Huidige schrijfpraktijk, met een toenemende rol van AI in analyse, ordening en formulering |
Ik zou Slimmefinanciering en Blokjes & Pijltjes eerst afzonderlijk analyseren. Pas daarna voegen we ze eventueel samen tot één “oude Rudy”-referentie. Anders verdwijnen interessante verschillen tussen je twee vroegere schrijfvormen in één gemiddelde. Ook Rudymentair moeten we niet als één blok behandelen. Idealiter onderscheiden we daar minstens:
- Rudymentair vóór intensief AI-gebruik;
- vroege experimenten met AI;
- de huidige werkwijze, waarin AI steeds meer als denk- en analysepartner wordt gebruikt.
Dat levert een ontwikkeling op in plaats van slechts een vergelijking tussen websites.
Het mini-model
Voor versie 0.1 zijn ongeveer twintig kenmerken voldoende. Elk artikel krijgt per kenmerk een score van 1 tot 5, een korte onderbouwing en een betrouwbaarheidsscore.
A. Structuur en lineariteit
| Kenmerk | Lage score | Hoge score |
|---|---|---|
| Lineariteit | Veel zijpaden en terugkoppelingen | Eén duidelijke lijn van begin naar conclusie |
| Symmetrie | Onderdelen verschillen sterk in lengte en vorm | Net geordende, gelijkwaardige onderdelen |
| Routevoorspelbaarheid | De tekst ontdekt onderweg zijn richting | De opbouw ligt vanaf het begin vast |
| Nette afronding | Spanningen blijven bestaan | Alle lijnen worden samengevat en afgesloten |
B. Uitleg en explicietheid
| Kenmerk | Lage score | Hoge score |
|---|---|---|
| Thematische explicietheid | De lezer moet zelf betekenis afleiden | De centrale les wordt uitgesproken |
| Herhaling van de kern | Een gedachte wordt eenmaal neergezet | Dezelfde kern verschijnt in meerdere formuleringen |
| Lezersbegeleiding | Abrupte overgangen en impliciete verbanden | Veel aankondigingen, tussenconclusies en wegwijzers |
| Samenvattingsdrang | Eindigt open of terloops | Eindigt met een keurige synthese |
C. Ambiguïteit en intellectuele spanning
| Kenmerk | Lage score | Hoge score |
|---|---|---|
| Tegenstrijdigheid | Tegenstellingen worden opgelost | Botsende verklaringen blijven naast elkaar staan |
| Morele ambiguïteit | Duidelijke helden, daders en oplossingen | Partijen zijn tegelijk begrijpelijk en problematisch |
| Zelfcorrectie | De auteur presenteert een afgerond oordeel | De auteur twijfelt, herroept of corrigeert zichzelf |
| Ongemak | De conclusie voelt geruststellend | De analyse laat een onprettige rest achter |
D. Causaliteit en systeemdenken
| Kenmerk | Lage score | Hoge score |
|---|---|---|
| Causale diepte | Gebeurtenissen worden beschreven | Mechanismen en terugkoppelingen worden uitgewerkt |
| Meervoudige verklaring | Eén hoofdoorzaak | Meerdere elkaar beïnvloedende oorzaken |
| Systeemniveau | Individueel gedrag en persoonlijke keuzes | Instituties, prikkels, bezit, macht en afhankelijkheden |
| Onbedoelde gevolgen | Beleid heeft een direct gewenst effect | Goede bedoelingen produceren tegengestelde uitkomsten |
E. Persoonlijke eigenheid
| Kenmerk | Lage score | Hoge score |
|---|---|---|
| Concrete persoonlijke ervaring | Algemene voorbeelden | Specifieke herinneringen, bedrijven, personen en situaties |
| Idiosyncratische associatie | Verwachte voorbeelden | Onverwachte verbindingen tussen onderwerpen |
| Emotionele ruwheid | Afgewogen en afstandelijk | Irritatie, verbazing, spot, fascinatie of verwarring |
| Talige oneffenheid | Glad en professioneel | Eigen ritme, tussenzinnen, uitroepen en kleine ontsporingen |
F. Bronnen en intellectuele beweging
| Kenmerk | Lage score | Hoge score |
|---|---|---|
| Bronconfrontatie | Bronnen ondersteunen hetzelfde punt | Bronnen botsen of corrigeren elkaar |
| Historische beweging | Alleen het actuele geval | Sprongen tussen heden, geschiedenis en eigen archief |
| Ontwikkeling van het denken | De auteur wist het antwoord al | De conclusie ontstaat zichtbaar tijdens het schrijven |
| Archiefverbinding | Artikel staat op zichzelf | Verwijst naar eerdere fascinaties, vergissingen en denklijnen |
Dit is geen letterlijke verkleining van de StoryScope-taxonomie. We nemen het principe over en vertalen het van fictie naar economische, politieke en persoonlijke essays.
Hoe de analyse werkt
Stap 1 — teksten verzamelen
De beste invoer is niet het live scrapen van de websites, maar de WordPress-exportbestanden in XML-formaat. Daarin staan doorgaans:
- titel;
- publicatiedatum;
- volledige artikeltekst;
- categorieën en tags;
- oorspronkelijke URL;
- status van het bericht.
We verwijderen vervolgens automatisch:
- HTML-opmaak;
- menu- en navigatietekst;
- afbeeldingen en onderschriften;
- ingesloten scripts;
- herhaalde auteursblokken;
- artikelen die alleen uit een verwijzing of zeer korte mededeling bestaan.
Stap 2 — blind beoordelen
De beoordelaar mag tijdens het scoren niet weten:
- van welke site de tekst komt;
- uit welk jaar hij komt;
- of AI bij de tekst betrokken was.
Alle teksten krijgen neutrale nummers. Anders gaat de beoordelende AI onbewust zoeken naar het verwachte verschil. StoryScope gebruikt eveneens een LLM om per dimensie vaste kenmerken uit teksten te halen en zet die daarna om in gestandaardiseerde categorieën. Voor onze lichte versie kunnen we alle twintig kenmerken in één of twee beoordelingsrondes laten bepalen, in plaats van tien afzonderlijke modelaanroepen per artikel.
Stap 3 — geen classifier, maar profielen
We hoeven aanvankelijk geen machine-learningmodel te trainen. We berekenen eenvoudig:
- gemiddelde score per kenmerk;
- spreiding tussen artikelen;
- verschillen tussen sites;
- veranderingen door de tijd;
- verschil tussen korte en lange artikelen;
- verschil per onderwerp;
- afstand tot het oude persoonlijke referentieprofiel.
Bijvoorbeeld:
| Kenmerk | Oude Rudy | Rudymentair vroeg | Rudymentair recent | Verandering |
|---|---|---|---|---|
| Lineariteit | 2,4 | 2,8 | 4,1 | Sterk toegenomen |
| Expliciete uitleg | 2,1 | 2,9 | 4,3 | Sterk toegenomen |
| Zelfcorrectie | 4,0 | 3,7 | 3,2 | Iets afgenomen |
| Systeemdenken | 3,6 | 4,1 | 4,7 | Toegenomen |
| Persoonlijke casussen | 4,2 | 3,8 | 3,1 | Afgenomen |
| Nette afronding | 2,0 | 2,7 | 4,2 | Sterk toegenomen |
Dat is slechts een voorbeeld van de uitvoer, geen verwachting over de werkelijke uitkomst.
Het belangrijkste methodologische probleem
Een verschil tussen de websites is niet automatisch een AI-effect.
Slimmefinanciering kan bijvoorbeeld vooral bestaan uit:
- vakinhoudelijke artikelen;
- financieringscasussen;
- een ander publiek;
- kortere of langere stukken;
- teksten uit een andere levensfase.
Rudymentair bevat mogelijk meer:
- politieke en filosofische beschouwingen;
- terugblikken;
- bronnenonderzoek;
- dialogen met AI;
- langere samengestelde teksten.
Daarom maken we naast de grote vergelijking ook gematchte deelvergelijkingen:
- economie tegenover economie;
- persoonlijke casus tegenover persoonlijke casus;
- boekbespreking tegenover boekbespreking;
- ongeveer gelijke tekstlengtes;
- artikelen met en zonder expliciete AI-bewerking;
- liefst enkele oude en nieuwe artikelen over hetzelfde terugkerende thema.
Juist artikelen waarin je na tien of vijftien jaar terugkeert naar hetzelfde onderwerp kunnen bijzonder informatief zijn.
Wat de uiteindelijke tool toont
1. Corpusprofiel
Een overzicht van ieder tijdvak:
- gemiddelde scores;
- spreiding;
- meest typerende kenmerken;
- kenmerken waarop de artikelen sterk uiteenlopen.
2. Tijdlijn
Per jaar of periode zien we bijvoorbeeld of:
- teksten geleidelijk lineairder worden;
- samenvattingen toenemen;
- persoonlijke anekdotes afnemen;
- systeemdenken sterker wordt;
- twijfel of ambiguïteit verandert.
3. Artikelvergelijker
Twee artikelen naast elkaar, met per kenmerk:
- score;
- korte verklaring;
- concrete tekstpassages als bewijs;
- verschil tussen de artikelen.
4. “Oude Rudy”-afstand
Geen AI-percentage, maar bijvoorbeeld: Dit artikel ligt qua opbouw dicht bij het recente Rudymentair-profiel, maar behoudt op persoonlijke casuïstiek en ambiguïteit veel kenmerken van het oude Slimmefinanciering-profiel.
5. Verlies- en winstkaart
Dit wordt waarschijnlijk het interessantste eindproduct:
| Mogelijke winst | Mogelijk verlies |
|---|---|
| Meer structuur | Minder spontane omwegen |
| Duidelijkere mechanismen | Meer uitleg dan nodig |
| Sterkere synthese | Te nette conclusies |
| Bredere bronnenbasis | Minder persoonlijke concreetheid |
| Beter systeemoverzicht | Minder zichtbare zoektocht |
| Minder herhaling door redactie | Of juist meer AI-achtige kernherhaling |
Technische opzet
Voor de eerste versie zou ik geen ingewikkelde webapp en geen getraind model bouwen.
Rudy StoryScope 0.1
- Python-script leest drie WordPress-XML-bestanden.
- Artikelen worden schoongemaakt en opgeslagen in een lokale database.
- Een vaste beoordelingsprompt scoort de twintig kenmerken.
- Iedere score bevat een korte onderbouwing en bewijsfragment.
- Resultaten worden opgeslagen als JSON of CSV.
- Een lokaal dashboard toont tabellen, tijdlijnen en vergelijkingen.
Een eenvoudige mappenstructuur:
rudy-storyscope/
├── PROJECTLOG.md
├── data/
│   ├── raw/
│   ├── cleaned/
│   └── analyses/
├── taxonomy/
│   └── rudy_features.json
├── scripts/
│   ├── import_wordpress.py
│   ├── clean_articles.py
│   ├── create_batches.py
│   └── calculate_profiles.py
├── dashboard/
└── README.md
Voor versie 0.1 kunnen we de tool batches laten maken die hier in ChatGPT worden beoordeeld en de JSON-antwoorden weer importeren. Dan is geen aparte betaalde API nodig. Later kan dezelfde architectuur worden gekoppeld aan een API of een lokaal model.
Voorlopig PROJECTLOG
| Onderdeel | Keuze |
|---|---|
| Doel | Verandering in Rudy’s schrijf- en denkprofiel zichtbaar maken |
| Geen doel | Bewijzen dat afzonderlijke teksten door AI zijn geschreven |
| Referentie | Slimmefinanciering en Blokjes & Pijltjes |
| Vergelijking | Rudymentair, liefst verdeeld in meerdere perioden |
| Methode | Circa twintig interpreteerbare kenmerken, scores 1–5 |
| Bewijs | Elke score krijgt een korte toelichting en tekstfragment |
| Eerste corpus | Beginnen met een representatieve steekproef, daarna opschalen |
| Eerste techniek | WordPress-XML → schone teksten → JSON-analyse → dashboard |
| Belangrijk risico | Onderwerp-, lengte- en periodeverschillen verwarren met AI-effect |
| Niet doen | Een misleidend percentage “door AI geschreven” tonen |
| Eerste resultaat | Profieltabel oude Rudy versus verschillende Rudymentair-perioden |
| Volgende stap | De drie WordPress-exportbestanden verzamelen en de definitieve taxonomie vastleggen |
Mijn voorstel is om te beginnen met twintig artikelen per corpus of periode. Daarmee kunnen we het model kalibreren, onbruikbare kenmerken verwijderen en ontdekken welke onverwachte verschillen werkelijk interessant zijn. Daarna kunnen we het volledige archief verwerken.
Maak een samenvatting van dit artikel voor de newbie. Reflecteer op een vertaling hiervan voor eigen gebruik, minder hoogdravend, meer praktisch, toepasbaar op eigen Nederlandse (blog-) teksten. Ook ben ik benieuwd naar de tijdelijkheid van dit soort exercities omdat AI snel leert en nieuwe regels kan incorporeren.
Samenvatting voor de leek
Het onderzoeksteam (UMD + Google DeepMind) liet vijf grote taalmodellen (Claude, GPT, Gemini, DeepSeek, Kimi) en mensen dezelfde verhaalpremisses schrijven — ruim 60.000 verhalen in totaal. In plaats van te kijken naar stijl (woordkeuze, zinsbouw, het beruchte AI-gebruik van het gedachtestreepje) keken ze naar de verhaalconstructie zelf: hoe wordt een plot opgebouwd, hoe expliciet wordt een thema uitgelegd, hoe lineair verloopt de tijd, hoe vaak breekt de verteller de vierde wand.
Belangrijkste bevindingen:
- Alleen al op basis van dit soort structurele keuzes (zonder stijl) is 93% nauwkeurig te zeggen of iets AI of mens is.
- AI-verhalen leggen thema’s expliciet uit (de verteller vertelt de moraal), zijn causaal opgeruimd, hebben nauwelijks subplots, en tonen emoties vooral via lichaam/omgeving in plaats van er gewoon “hij voelde angst” te zeggen.
- Mensen zijn rommeliger: meer tijdsprongen, meer morele ambiguïteit, meer verwijzingen naar andere concrete werken, vaker rechtstreekse aanspreking van de lezer.
- De vijf AI-modellen lijken structureel sterk op elkaar en vormen een aparte, kleine cluster; mensen zijn diverser en “zeldzamer” in dit kenmerkenlandschap.
- Zelfs na het wegpolijsten van stijl-artefacten (cliché’s, purple prose) blijft detectie bijna even goed — de structuur zit dieper dan de stijl.
Vertaling naar praktisch, bruikbaar voor jouw teksten
Even loskoppelen van het wetenschappelijke jargon: dit is eigenlijk een checklist van tics die je in eigen AI-geassisteerde blogteksten kunt opsporen en wegpoetsen, los van of het “verraadt” dat het AI is — het zijn ook gewoon zwaktes in schrijven.
Zelfcheck voor een concept-blogpost:
- Legt de tekst de conclusie te veel uit aan het einde? Eindig je met een samenvattend “en dit laat zien dat…” zinnetje? Dat is precies het AI-patroon (77% vs 52% bij mensen). Bij jouw werk relevant: je extractiecyclus- of tienprincipes-stukken hebben vaak al een sterke interne logica — de verleiding is om die logica ook nog eens expliciet te herhalen aan het slot. Vaak kan die laatste alinea weg.
- Is het te opgeruimd? Één rechte lijn van observatie naar these naar conclusie, zonder zijpaden of tegenvoorbeelden die je zelf ook serieus overweegt? Mensen (en jouw beste stukken) laten juist ruimte voor een subplot dat niet meteen netjes bij het hoofdthema aansluit.
- Gebruik je lichaam/sfeer als vervanger voor het benoemen van iets? Dit is meer voor fictie, minder relevant voor jouw analytische register, maar het analoog voor essayistiek is: verstop je een zwakke schakel in het argument achter sfeervolle taal in plaats van ‘m gewoon te benoemen?
- Zit er een concrete, met naam genoemde verwijzing in, of alleen vage echo’s? Mensen verwijzen bijna twee keer zo vaak naar specifieke, benoemde bronnen. Dit is een sterk punt voor jou — je citeert altijd expliciet Olson, Hirsch, Pirsig, Van Teutem. Blijf dat doen, dat is precies het “menselijke” signaal.
- Spreek je de lezer aan? Rechtstreekse aanspreking (fourth-wall breaking) komt bij mensen bijna twee keer zo vaak voor. Jouw “ik schrijf dit vooral voor mezelf” toon is hier al een natuurlijk tegenwicht tegen AI-gladheid.
Kortom: als praktische vuistregel voor je eigen concepten — laat een subplot bungelen, benoem een concrete bron met naam, en knip de laatste “en dus concludeer ik”-alinea eruit als hij er al staat in de tekst zelf.
De tijdelijkheidsvraag — en waarom die serieuzer is dan de auteurs toegeven
Jij legt precies de vinger op de zere plek, en het is het minst overtuigende deel van het paper.
De auteurs claimen dat narratieve kenmerken duurzamer zijn dan stilistische, omdat stijl met simpele post-hoc edits weg te poetsen is (zoals ze zelf laten zien: LAMP-herschrijving verwijdert stijl-artefacten, maar drukt de detectiescore maar 1,6 punt omlaag), terwijl structuur “significante herschrijvingen” zou vergen. Dat onderscheid is echt, maar het is een verschil in kosten, niet in onmogelijkheid.
Een paar dingen die tegen duurzaamheid pleiten:
- Het paper zelf laat zien dat modelmakers al razendsnel reageren op stijlkritiek (GPT 5.4 verminderde het gedachtestreepje-gebruik nadat dat een bekend AI-signaal werd). Er is geen reden om aan te nemen dat “schrijf een subplot dat niet netjes bij het thema past” of “eindig ambigu in plaats van met een moraal” wezenlijk moeilijker te finetunen is dan stijl — het is alleen een duurdere trainingsinterventie (RLHF op verhaalstructuur in plaats van op woordkeuze), niet een fundamenteel andere orde probleem.
- Zodra dit soort onderzoek publiek is — en dat is het nu, met code en featuretaxonomie erbij — wordt het een expliciete specificatie. Een systeem-prompt als “vermijd expliciete thema-uitleg, bouw een subplot in dat niet perfect thematisch aansluit, eindig moreel ambigu” zou een groot deel van deze 30 kernkenmerken direct kunnen neutraliseren zonder dat het model “begrijpt” waarom — precies zoals stijl-detectoren omzeild worden door instructies over em-dashes te geven.
- Dus het echte verschil is niet permanent vs. tijdelijk, maar eerder: stijl is een toevallig bijproduct van training dat modelmakers nog niet hadden geoptimaliseerd, en narratieve structuur is een dieper bijproduct dat nog niet was geoptimaliseerd. Zodra de optimalisatiedruk er ligt (en dit paper creëert die druk, want het is nu een benchmark), verdwijnt het verschil grotendeels.
Wat waarschijnlijk wél blijft plakken, is niet dit specifieke featurelijstje maar het onderliggende mechanisme: elk sterk RLHF-getraind model convergeert naar een smalle, “veilige” verdeling van keuzes, omdat afwijkende, gewaagde keuzes (moreel ambigu einde, een amateuristisch bungelende subplot) door menselijke reviewers vaker als “minder goed” worden beoordeeld dan een net afgeronde, thematisch coherente versie. Dat is een structureel kenmerk van hoe deze modellen getraind worden, niet van wat ze toevallig nog niet geleerd hebben — en dat mechanisme is inderdaad moeilijker weg te trainen, want het zit in de optimalisatiedoelstelling zelf (menselijke voorkeur voor coherentie en netheid), niet in een los te repareren symptoom.
Kort gezegd: de symptomen in dit paper zijn met vrij lage moeite te patchen zodra ze bekend zijn (en dat zijn ze nu). De oorzaak — RLHF-conforme output trekt naar het gemiddelde — is veel taaier, en daar zou ik als hypothese voor een volgend stuk op inzetten in plaats van op deze specifieke 30 features, die over een jaar waarschijnlijk grotendeels gecorrigeerd zijn in nieuwe modelversies.
