810 Het einde van het lineaire non-fictie boek
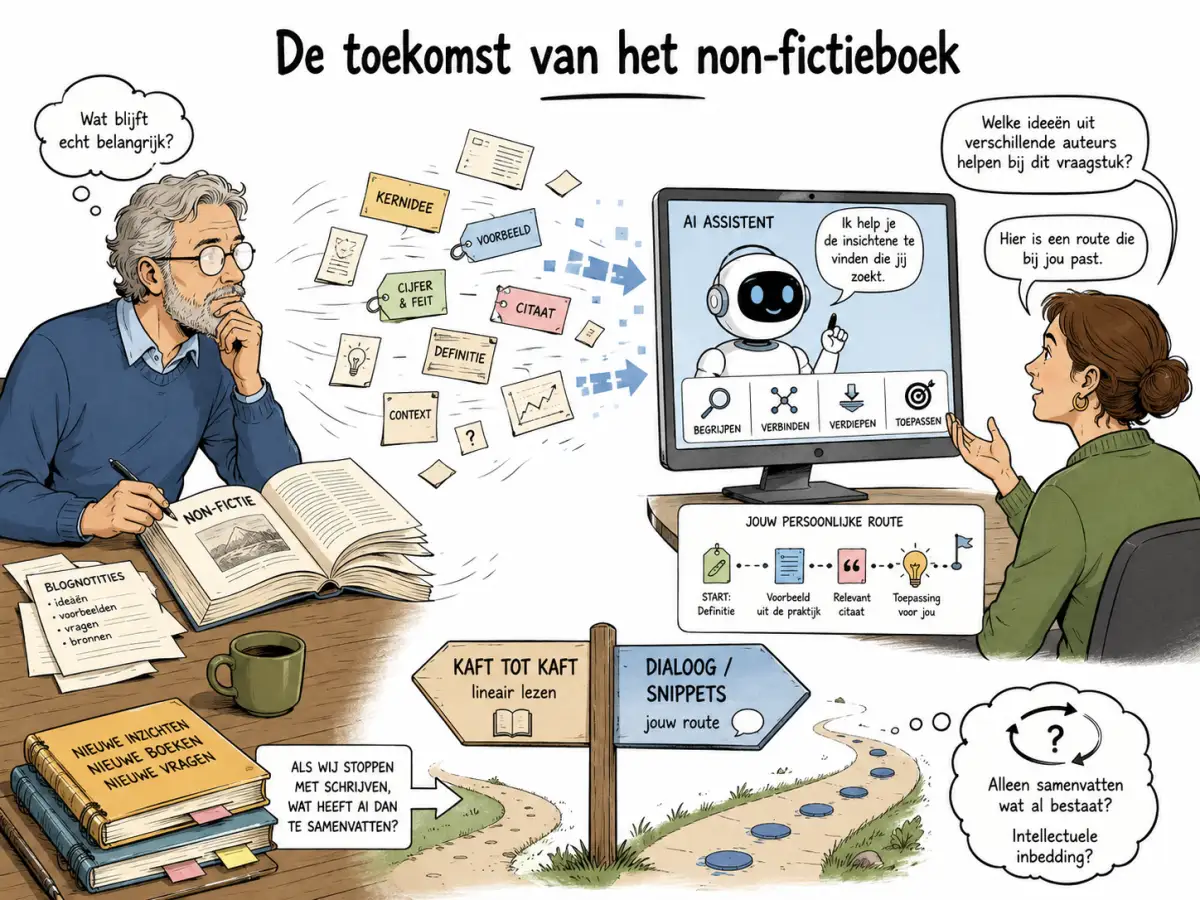
Ik was met iemand in gesprek over de toekomst van het non-fictie boek. Ook hij las zelfs het originele werk niet meer, liet AI een samenvatting maken. Maar ja, zo was de redenering, er moet wel aanwas blijven van dat soort (wetenschappelijke) boeken anders kan AI er geen samenvattingen meer van maken. Aha, ja dat is mogelijk een gevolg, maar lijkt me geen goede reden voor een wetenschapper om dan maar dat boek te blijven maken, want geen lezers meer, hooguit AI-agenten. Toen bedacht ik me dat ik al vaker over dit onderwerp heb geschreven. Maar versnipperd, ik heb er zelf geen overzicht meer van, dus hoe kon ik dat nu simpel even ophalen? Wat een paradox, ik doe zelf eigenlijk al wat mijn vraag is, ik schrijf losse dingen op zoals ze dan uitkomen, maar ze staan alleen chronologisch achter elkaar. Dus laat ik NotebookLM (die nu anders is gaan heten btw Gemini Notebook) die ‘filosofie’ eens opschrijven. Maar ik wil verder gaan, zijn er meer mensen die dit zo zien, wat zijn de bronnen, hoe zal dat mogelijk gaan in de toekomst, krijgen we geen inteelt als nieuwe bronnen uitblijven? En ja het zal natuurlijk wel zo blijven dat we gevonden willen worden. Als niet door lezers, dan door AI-agenten, dan moeten we daar in the picture komen. Hoe doen we dat? Door interessante ophaalsnippers aan te bieden met de juiste tags, labels en wat niet al. Je kunt jezelf dan wellicht onderscheiden door er een leeswijzer of optionele visie bij te leveren. Wilt u de losse fragmenten of liever de ‘wrapper’ erbij? Waar wetenschappers voorlopig nog wel in hun verplichte stramien zullen blijven (het zal nog lang duren voordat je kunt promoveren op een verzameling snippers gedachten …), hoe zal dat gaan voor de kranten, nieuwsbrieven, media, die er hun brood mee moeten verdienen. Ik wil dit onderwerp een stapje verder brengen, niet alleen maar wat vragen stellen en scenario’s opperen.
Vat samen wat de auteur meldt over de toekomst van het boek. Met name de invloed van AI en het lineair lezen van een non-fictie boek. Het vermoeden is dat lezers worden vervangen door AI-agenten. De samenvatting door AI is te verleidelijk om zelf nog te lezen. Boeiender is het in dialoog gaan met het boek of de samenvatting op maat en vanuit je eigen vragen en thematieken. Wat dan weer de vraag stelt: waarom zou je als auteur nog een lineair boek schrijven van kaft tot kaft met inhoudsopgave vanuit jouw perspectief? Natuurlijk als je het voor de fun doet, of om je eigen gedachtes te ordenen of als je het moet doen vanuit een verplichting als proefschrift etc. Je zou beter snippets of losse elementen kunnen aanbieden en dan indien gewenst een voorkeursroute of leeswijzer kunnen maken voor de ‘in dialoog gaander’ of voor de ‘ai agent’. Als ik dat zo intik is dat wat ik nu doe met mijn blogs, met dien verstande dat ik helemaal niet zo’n leesstrategie heb maar eerder omgekeerd ai mij laat vertellen wat de rode lijn is en of er uberhaupt een overkoepelende filosofie of bundeling is. De ultieme vraag is wel: wat als de serieuze auteurs dus geen boeken meer schrijven, waar moet ai dan nog zijn samenvattingen op baseren? En hoe voorkomen we inteelt en eeuwig gedraai in dezelfde soep van bestaande gedachtes?
De auteur schetst een toekomst waarin het traditionele lineaire non-fictieboek en de klassieke manier van lezen onder grote druk staan door de opkomst van AI. Hieronder volgt een samenvatting van zijn bevindingen op basis van de bronnen:
De verschuiving van lineair lezen naar dialoog
- Het einde van de lineaire lezer: De auteur stelt vast dat steeds minder mensen een non-fictieboek nog van kaft tot kaft lezen. Lezers zijn veranderd in “informatie-gebruikers” die scannend of “just-in-time” lezen: ze zoeken alleen de fragmenten die ze op dat moment nodig hebben.
- Boek als grondstof: Een boek is niet langer een afgerond eindstation, maar wordt een “database van ideeën” of een “argumentenbank”.
- Dialogisch lezen: De lezer gaat via AI in dialoog met de tekst. Het boek fungeert als anker voor een gesprek waarbij de lezer de regie overneemt en de volgorde, diepte en relevantie bepaalt.
De veranderende rol van de auteur
- Verlies van regie: De auteur verliest de controle over de leeservaring. Omdat de AI-samenvatting vaak “goed genoeg” is, wordt de verleiding groot om het originele werk helemaal over te slaan.
- Auteur als gids: Schrijvers moeten zichzelf opnieuw definiëren als curatoren, essayisten of gidsen. Hun taak is niet meer het vastleggen van een definitieve waarheid, maar het aanbieden van een “denkobject” of “kennissysteem” waarmee anderen aan de slag kunnen.
- Snippets en archieven: De auteur ziet zijn eigen werk (honderden blogs) inmiddels zelf niet meer als een lineair verhaal, maar als een “interactief archief” of “mentale bibliotheek”. Dit format is volgens hem beter geschikt voor het AI-tijdperk dan een statisch boek.
De “Ultieme Vraag”: Het risico van intellectuele inteelt
De auteur benoemt scherpe risico’s voor de toekomst van kennisproductie:
- Google Zero en de “slang die zichzelf opeet”: AI-modellen voeden zich met bestaande journalistieke en intellectuele content, maar ondermijnen tegelijkertijd het verdienmodel van die bronnen (minder doorkliks). Als bronnen opdrogen, heeft AI geen verse brandstof meer.
- Model Collapse: Er ontstaat een gevaarlijke cirkelredening wanneer AI wordt getraind op de output van andere AI-modellen. Dit leidt tot een regressie naar het gemiddelde: teksten worden “gladgestreken”, uniform en verliezen hun oorspronkelijkheid en scherpte.
- Papier-maché-kennis: Zonder nieuwe, diepgravende menselijke input ontstaat er “papier-maché-kennis”: informatie die weliswaar vloeiend en geloofwaardig klinkt, maar feitelijk hol en contextloos is.
Hoe inteelt te voorkomen?
Volgens de auteur ligt de oplossing in het creëren van content die zich niet makkelijk laat reduceren tot een simpele samenvatting:
- Weerbarstige boeken: Alleen boeken die gelaagd, ambigu en soms zelfs tegenstrijdig zijn—en dus menselijke denkkracht vereisen om werkelijk te begrijpen—zullen overleven.
- Van website naar “Atlas”: Schrijvers moeten hun platforms minder “snippetbaar” maken. In plaats van losse artikelen moeten ze bronomgevingen of “atlassen” bouwen waarin de samenhang, persoonlijke stijl en de ontwikkeling van het denken centraal staan.
- Originaliteit door “irritatie”: AI kan samenvatten, maar ervaart geen pijn, verwondering of noodzaak. De menselijke uniekheid blijft liggen in de selectie van onderwerpen, de provocatie en de persoonlijke visie die AI nooit zelf zou verzinnen.
Wat we kunnen toevoegen
De aangeleverde samenvatting raakt de kern, maar blijft nog hangen in de tegenstelling: óf een traditioneel boek, óf losse snippets voor AI. De interessantere conclusie is volgens mij: Het non-fictieboek verdwijnt niet, maar verliest zijn monopolie als verpakking van kennis. Een auteur maakt straks niet noodzakelijk één eindproduct, maar onderhoudt een bronlichaam waaruit verschillende verschijningsvormen kunnen worden gemaakt:
- een lineair boek;
- een korte leesroute;
- een thematische selectie;
- een actuele versie;
- een dialoog met een AI;
- een machineleesbare verzameling beweringen, bronnen en voorbeelden.
Het boek wordt dan één mogelijke interface op de kennis, naast andere interfaces.
Je had dit inderdaad al eerder bedacht
Je gedachtegang blijkt opvallend consistent, maar ontwikkelt zich in stappen. In blog 94 vroeg je je al af of ook fictie uiteindelijk niet door een interactieve verteller kan worden vervangen: geen vast verhaal lezen, maar een persoonlijk verhaal binnengaan. In blog 600b werd het traditionele non-fictieboek al min of meer doodverklaard ten gunste van een interactief archief. (Rudy’s ruimte). Blog 675 beschrijft vervolgens precies hoe je zelf werkt: eerst losse fiches, observaties en gesprekken verzamelen, daarna AI gebruiken om er een mogelijke volgorde en een lineair boek van te maken. In blog 713 draai je het perspectief om: als de lezer toch via een AI-tussenpersoon binnenkomt, waarom zou je dan nog zoveel moeite doen om vooraf één vaste website of boekstructuur te construeren? (Rudy’s ruimte). Je huidige vraag is daarmee bijna de omkering van blog 675:
- eerst: hoe kan AI mijn fragmenten tot een boek ordenen?
- nu: waarom zouden die fragmenten eigenlijk nog tot één boek moeten worden geordend?
Het werkelijk nieuwe element is nu de vervolgvraag: wat gebeurt er met de kennisproductie als iedereen alleen nog de afgeleide AI-versie consumeert?
Drie zaken die uit elkaar moeten worden gehouden
De samenvatting gooit drie verschillende ontwikkelingen enigszins op één hoop.
1. Verandering van het lezen
AI neemt bepaalde leesfuncties over:
- zoeken;
- oriënteren;
- samenvatten;
- vergelijken;
- vertalen;
- uitleggen;
- passages selecteren vanuit een persoonlijke vraag.
Dat betekent nog niet dat AI alle functies van lezen overneemt. Een boek lezen is ook:
- langere tijd in iemands denkwijze verblijven;
- meemaken hoe een redenering zich ontvouwt;
- weerstand en verveling doorstaan;
- zelf verbanden leggen;
- langzaam van mening veranderen;
- onverwacht iets tegenkomen waar je niet naar zocht.
De wetenschappelijke literatuur over AI bij lezen en schrijven laat zowel voordelen als risico’s zien: meer ondersteuning, personalisering en ordening, maar ook afhankelijkheid, minder metacognitieve inspanning en mogelijk verlies aan kritisch engagement. Specifiek onderzoek waarin het lezen van hele non-fictieboeken wordt vergeleken met alleen AI-samenvattingen is nog beperkt. (Frontiers). De samenvatting is dus niet noodzakelijk een slechtere informatieoverdracht. Maar zij is wel een andere denkervaring.
2. Verandering van het publicatieformaat
De vaste bundeling van kennis in ongeveer driehonderd pagina’s was nooit een natuurwet. Zij was mede het gevolg van drukwerk, distributie, boekhandels, bibliotheken, auteursrecht en academische beoordelingssystemen. Het idee van vloeibare, netwerkachtige en veranderlijke boeken bestond al vóór generatieve AI. Bob Stein experimenteerde met het “networked book”; Janneke Adema beschrijft het wetenschappelijke boek als een levend, gezamenlijk en herbruikbaar project in plaats van als een vast, lineair object. (Toekomst van het Boek). AI maakt die oude gedachte ineens praktisch bruikbaar. De lezer hoeft niet meer zelf door alle hyperlinks, versies en fragmenten te navigeren. Een agent kan op verzoek een tijdelijke route samenstellen.
3. Verandering van de productieprikkel
Dit is de zwaarste kwestie. Wie betaalt nog voor:
- langdurig onderzoek;
- veldwerk;
- interviews;
- archiefonderzoek;
- originele dataverzameling;
- jaren nadenken;
- journalistieke aanwezigheid ter plaatse?
Niet het verdwijnen van het boek is het grootste risico, maar het verdwijnen van de financiering van oorspronkelijk contact met de werkelijkheid.
Een bruikbaarder model: de kennisstapel
Je kunt het hele systeem in drie lagen verdelen.
| Laag | Wat gebeurt daar? | Kan AI dit overnemen? |
|---|---|---|
| Werkelijkheidslaag | Meten, observeren, interviewen, experimenteren, meemaken | Beperkt; AI kan helpen, maar niet zelfstandig garanderen dat iets werkelijk is waargenomen |
| Kennislaag | Beweringen, bewijs, voorbeelden, begrippen, tegenargumenten, bronverwijzingen | Zeer geschikt voor menselijke én machinale verwerking |
| Presentatielaag | Boek, artikel, college, podcast, samenvatting, dialoog, leesroute | In hoge mate automatiseerbaar en personaliseerbaar |
Het traditionele boek bindt deze drie lagen samen. De auteur onderzoekt, ordent en presenteert alles in één vorm. AI maakt het mogelijk die lagen los te koppelen. De auteur of onderzoeker produceert een kennislichaam; daarna kunnen verschillende menselijke of kunstmatige redacteuren er verschillende routes doorheen maken. Daarmee verandert de auteur van alleen een verhalenverteller in vier rollen:
- waarnemer en onderzoeker;
- maker van oorspronkelijke beweringen;
- bewaker van bewijs en herkomst;
- ontwerper van een voorkeursroute.
Die vierde rol blijft belangrijk. Anders geef je AI niet alleen de samenvatting, maar ook het recht om achteraf te bepalen wat jouw centrale filosofie eigenlijk was. Dat is precies wat nu bij je blogs gebeurt. Het levert verrassende ontdekkingen op, maar het betekent ook dat een model mede beslist welke rode draad zichtbaar wordt.
Waarom nog lineair schrijven?
Een inhoudsopgave is niet alleen een gebruiksaanwijzing. Zij is zelf een uitspraak. De auteur zegt ermee:
- dit probleem moet vóór dat probleem worden begrepen;
- deze definitie is nodig voordat ik mijn conclusie kan trekken;
- dit tegenargument krijgt pas hier betekenis;
- na deze drie hoofdstukken mag je mijn centrale stelling beoordelen.
Volgorde produceert betekenis.
In je eigen werkproces uit blog 675 ontdekte je dat ook: niet alleen de inhoud, maar vooral de ordening van de fiches veranderde het verhaal. (Rudy’s ruimte). Daarom zullen vooral deze boeken lineair blijven:
- boeken waarin het betoog zelf de ontdekking vormt;
- historische reconstructies;
- intellectuele biografieën;
- narratieve journalistiek;
- filosofische werken;
- boeken waarin stijl, ritme en ambiguïteit essentieel zijn.
Veel managementboeken, zelfhulpboeken, handleidingen, beleidsboeken en overzichtswerken zijn kwetsbaarder. Daarin wil de lezer vaak inderdaad slechts weten: Wat moet ik hiervan begrijpen voor mijn probleem? De toekomst wordt daarom waarschijnlijk geen einde van het boek, maar een splitsing:
- het boek als efficiënte informatiedrager wordt grotendeels opvraagbaar;
- het boek als geleide denkervaring blijft bestaan;
- het fysieke boek kan bovendien juist een premiumobject, cadeau, bewijs van ernst of statussymbool worden.
Worden lezers vervangen door agenten?
Niet helemaal. Er komt eerder een nieuwe eerste lezer tussen auteur en mens. De keten wordt: auteur → bron → AI-agent → persoonlijk antwoord → mens. Joshua Rothman beschreef in 2025 bijna exact deze ontwikkeling: teksten worden vloeibaar, verkort, omgevormd en gebruikt als tussenstation voor iets anders. Hij verwijst ook naar Tyler Cowen, die expliciet zei dat hij mede “voor de AI’s” begon te schrijven. (The New Yorker). De auteur krijgt daardoor drie publieken:
- de menselijke lezer, die stem, ervaring en interpretatie zoekt;
- de AI-agent, die duidelijke, betrouwbare en terugvindbare bouwstenen zoekt;
- de institutionele gebruiker, die herkomst, rechten, updates en aansprakelijkheid nodig heeft.
Dat derde publiek wordt belangrijker dan het op het eerste gezicht lijkt. Een bank, ministerie, universiteit of krant wil niet zomaar een vloeiende AI-samenvatting, maar wil weten:
- waar komt deze bewering vandaan?
- van wanneer is zij?
- is zij later gecorrigeerd?
- onder welke voorwaarden mag zij worden gebruikt?
- wat is feit en wat is interpretatie?
De echte inteelt: niet alleen model collapse
De aangeleverde tekst gebruikt terecht het begrip model collapse, maar dat is slechts één vorm van inteelt.
Technische inteelt
Bij model collapse worden nieuwe modellen steeds meer getraind op output van eerdere modellen. Daardoor kunnen zeldzame, afwijkende en minder waarschijnlijke gegevens verdwijnen en wordt de verdeling steeds vlakker. Het Nature-onderzoek benadrukt daarom het belang van toegang tot oorspronkelijke, door mensen geproduceerde gegevens. (Nature) Model collapse is overigens niet automatisch onafwendbaar. Onderzoek suggereert dat het probleem veel kleiner wordt wanneer oorspronkelijke gegevens behouden blijven en synthetische gegevens eraan worden toegevoegd in plaats van ze te vervangen. (arXiv)
Epistemische inteelt
Deze is voor jouw betoog belangrijker: Er verschijnen nog volop correcte teksten, maar er komen steeds minder nieuwe waarnemingen, afwijkende ervaringen en oorspronkelijke ideeën bij. AI kan dan technisch uitstekend blijven functioneren en toch steeds dezelfde bibliotheek opnieuw rangschikken. Een model kan:
- een oude theorie anders combineren;
- een nog niet gestelde vraag beantwoorden;
- een nieuwe hypothese voorstellen.
Maar het kan niet door tekstverwerking vaststellen:
- wat er vanmorgen in een bedrijf gebeurde;
- hoe een beleidsmaatregel werkelijk uitpakt;
- wat mensen niet tegen een enquêteur durven zeggen;
- welke uitzondering alle bestaande modellen tegenspreekt;
- wat een jarenlang experiment heeft opgeleverd.
Een AI kan een oude bibliotheek eindeloos goed samenvatten. Wat zij niet uit zichzelf kan leveren, is nieuw contact met de werkelijkheid.
Economische inteelt
Hier ontstaat een zichzelf versterkende lus:
betere AI-samenvattingen
→ minder bezoeken en aankopen
→ minder inkomsten en erkenning voor bronnen
→ minder oorspronkelijke productie
→ minder verse bronnen
→ minder goede toekomstige AI-antwoorden.
Bij Google-zoekopdrachten met een AI-samenvatting klikten gebruikers in Pew-onderzoek nog in 8% van de gevallen op een gewone zoekuitkomst, tegenover 15% zonder samenvatting. Op een bron in de AI-samenvatting zelf werd slechts bij ongeveer 1% van de bezoeken geklikt. (Pew Research Center) Dat bewijst niet dat boeken verdwijnen, maar wel dat het mechanisme waarover je schrijft al zichtbaar is: de afgeleide laag vangt de aandacht, terwijl de oorspronkelijke bron het werk heeft gedaan.
Dit is geen zuivere toekomstmuziek
Een aantal vormen die jij voorstelt bestaat al. Nanopublicaties zijn kleine, zelfstandig citeerbare en machineleesbare wetenschappelijke beweringen, voorzien van informatie over herkomst en methode. Ze kunnen mét of zonder traditioneel artikel worden gepubliceerd. (nanopub.net) Onder de noemer Agentic Publications wordt geëxperimenteerd met wetenschappelijke publicaties als interactieve kennissystemen met verschillende detailniveaus, gestructureerde data, kennisgrafen, verificatie en interfaces voor mensen én machines. (arXiv) Reuters lanceerde op 8 juli 2026 zelfs een eigen MCP-server waarmee AI-agenten van betalende klanten rechtstreeks Reuters-nieuws kunnen zoeken, ophalen en verwerken. Reuters publiceert daarmee niet meer uitsluitend voor mensen die een artikel openen, maar ook rechtstreeks voor machines die journalistiek materiaal in andere werkprocessen invoegen. (Reuters) Dat is bijna letterlijk jouw voorspelling.
Wat gebeurt er met kranten en media?
De presentatie wordt goedkoop; de bron wordt schaars. Een algemeen nieuwsbericht kan straks in talloze stijlen en lengtes worden gegenereerd. Waarde blijft vooral zitten in:
- als eerste ergens aanwezig zijn;
- toegang tot personen en documenten;
- verificatie;
- betrouwbaarheid;
- eigen dossiers en databases;
- een herkenbare interpretatie;
- juridische en redactionele verantwoordelijkheid.
De krant van de toekomst verkoopt mogelijk minder afzonderlijke artikelen en meer:
- betrouwbare feitenstromen;
- voortdurend bijgewerkte dossiers;
- toegang voor AI-agenten;
- licenties;
- controleerbare bronpakketten;
- communities rond bepaalde expertise;
- de garantie dat iemand werkelijk onderzoek heeft gedaan.
Uitgevers proberen inmiddels gezamenlijke standaarden en licentiemodellen te ontwikkelen, omdat afzonderlijke uitgevers zwak staan tegenover een klein aantal grote AI-platforms. (reutersinstitute.politics.ox.ac.uk) IAB Tech Lab werkt bijvoorbeeld aan protocollen waarbij machines toestemming kunnen vragen, gebruiksvoorwaarden meekrijgen en machineleesbaar verpakte content ontvangen. Het uitgangspunt wordt expliciet verschoven van betaling voor verkeer naar betaling voor de bijdrage van een bron aan een AI-uitkomst. (IAB Tech Lab) De grote politieke vraag wordt daarmee: Wie betaalt de laag die nog werkelijk gaat kijken?
Niet kiezen tussen snippets en een wrapper
Je voorstel kan nog één stap scherper. De oplossing is niet: Maak alleen losse fragmenten en voeg eventueel een leeswijzer toe. De oplossing is: Publiceer de bron modulair, maar behoud meerdere expliciete ordeningen. Een toekomstig kennisproduct kan uit vier onderdelen bestaan:
1. De oorspronkelijke stukken
Volledige essays, onderzoeken, interviews en observaties blijven beschikbaar als canonieke bron.
2. De kenniseenheden
Per stuk bijvoorbeeld:
- centrale bewering;
- gebruikte begrippen;
- bewijs en voorbeelden;
- tegenargument;
- onzekerheden;
- relaties met andere stukken;
- datum en versie.
3. De door de auteur gekozen route
Niet langer gepresenteerd als dé enige juiste volgorde, maar als: Dit is de route waarvan ik vind dat mijn gedachtegang het best tot zijn recht komt.
4. Door de lezer of agent gemaakte routes
Bijvoorbeeld:
- leg het uit vanuit de woningmarkt;
- verbind dit met meritocratie;
- toon alleen de tegenargumenten;
- maak een route voor beginners;
- laat zien hoe mijn ideeën sinds 2025 zijn veranderd;
- waar spreek ik mezelf tegen?
De lezer kan dus kiezen: Wilt u alleen de fragmenten, Rudy’s voorkeursroute, of een route op maat? Dat is sterker dan een simpele samenvatting. Het bewaart zowel de vrijheid van de gebruiker als het redactionele auteurschap.
Hoe kom je bij AI-agenten in beeld?
Waarschijnlijk minder door een wildgroei aan tags dan je denkt. Google zegt inmiddels expliciet dat er geen speciale AI-markering nodig is, dat pagina’s niet kunstmatig in minuscule brokken hoeven te worden gehakt en dat unieke, betrouwbare en oorspronkelijk door deskundigen gemaakte inhoud belangrijker blijft dan “schrijven voor het algoritme”. (Google for Developers) Voor jouw archief zijn vooral deze zaken nuttig:
- vaste, openbare en blijvende URL’s;
- duidelijke titels;
- auteur, publicatiedatum en wijzigingsdatum;
- een korte expliciete kernstelling;
- inhoudelijke koppelingen naar verwante blogs;
- bronverwijzingen;
- themapagina’s die meerdere blogs verbinden;
- een sitemap en RSS-feed;
- normale semantische HTML en eventueel gestructureerde metadata;
- een heldere scheiding tussen oorspronkelijke tekst en latere AI-samenvatting.
Daarnaast kun je toegang voor zoeken en toegang voor modeltraining verschillend behandelen. OpenAI maakt bijvoorbeeld onderscheid tussen OAI-SearchBot, waarmee content in zoekantwoorden kan verschijnen, en GPTBot, dat verband houdt met mogelijke training. (OpenAI Help Center) Een llms.txt-bestand of latere agentinterface kan een aanvullende inhoudsopgave voor machines worden, maar is geen magische vindbaarheidsknop. De wezenlijke voorsprong blijft: originele begrippen, goede verbanden, herkenbare voorbeelden, controleerbare bronnen en een consistente eigen stem.
Wat dit voor Rudymentair betekent
Je hoeft je blogs niet alsnog allemaal in één definitief boek te persen. Je bezit feitelijk al de eerste laag van het toekomstige kennisproduct: een groot chronologisch bronarchief. Wat nog ontbreekt is een tussenlaag van door jouzelf aangebrachte betekenis:
- een atlas van hoofdthema’s;
- per thema een korte actuele positiebepaling;
- verwijzingen naar de belangrijkste stukken;
- aangegeven ontwikkeling en eventuele tegenspraken;
- enkele door jou aanbevolen leesroutes;
- daarnaast de vrije AI-ingang.
Daarmee voorkom je twee uitersten:
- de bezoeker moet achthonderd blogs chronologisch lezen;
- een AI mag geheel zelfstandig bepalen wat “de filosofie van Rudy” is.
Je krijgt dan naast elkaar:
Het archief zoals het ontstond
De kaart zoals Rudy hem nu tekent
De route die de bezoeker zelf laat maken
De scherpste centrale these
Volgens mij kan het vervolg hierop rusten:
AI maakt het boek niet overbodig doordat zij beter schrijft, maar doordat zij de verpakking losmaakt van de inhoud. De auteur van de toekomst publiceert daarom niet alleen een boek, maar een controleerbaar kennislichaam met meerdere mogelijke routes. Het echte gevaar is niet dat niemand het oorspronkelijke boek leest, maar dat niemand nog betaalt voor het oorspronkelijke kijken, onderzoeken en denken waarop alle afgeleide antwoorden rusten.
Dat brengt je voorbij de vrijblijvende voorspelling. Het wordt een systeemvraag over:
- vorm;
- aandacht;
- eigendom;
- inkomsten;
- bronproductie;
- menselijke denkarbeid;
- en de machtspositie van de partij die tussen bron en gebruiker komt te staan.
En ja: NotebookLM heet sinds 16 juli 2026 officieel Gemini Notebook. (blog.google)
Oneens met het gebrek aan tussenlaag, ik heb als hoofdingang een thematisch overzicht van mijn site met links en verwijzingen en wat niet al, en zelfs een ai-instructie! https://rudymentair.nl/alfabetische-inhoudsopgave/ en https://rudymentair.nl/instructie-ai-google/
Je hebt gelijk. Mijn zin dat de tussenlaag ontbrak was gewoon onjuist en deed geen recht aan wat er al staat. Je site heeft inmiddels juist vier toegangslagen:
- Het chronologische bronarchief
De ruim achthonderd blogs zoals ze tijdens het denken zijn ontstaan. - De boekachtige en thematische tussenlaag
De inhoudsopgave noemt zichzelf expliciet een boekachtige toegang tot het archief, met een compacte leeswijzer, tien hoofdthema’s, een personenindex, begrippenindex en artikelindex. Het is dus niet slechts een alfabetisch lijstje, maar precies een atlas van rode draden en mogelijke routes. (Rudy’s ruimte) - De door jou aangebrachte interpretatieve wrapper
In de AI-instructie leg je zelf vast wat de onderliggende hoofdvraag is — hoe systemen werkelijk werken wanneer belangen, status, schaarste, macht en prikkels een rol spelen — en welke begrippen daarbij centraal staan. Je laat dus niet uitsluitend aan AI over wat jouw filosofie zou zijn. (Rudy’s ruimte) - De dialogische ingang
Via NotebookLM/Gemini Notebook kan een bezoeker vanuit een eigen vraag met de hele bloggeschiedenis in gesprek. Op je site staat zelfs al letterlijk dat lezen van voor tot achter voorbij is. (Rudy’s ruimte)
Mijn eerdere voorstelling: losse blogs → ontbrekende tussenlaag → eventueel later een atlas, moet dus worden vervangen door: losse blogs → thematische atlas → auteursinstructie → persoonlijke AI-dialoog. Dat is nogal een verschil. Je schrijft niet alleen óver de toekomst van het non-fictieboek; Rudymentair is al een praktisch prototype ervan.
Waar zit dan nog wél de interessante spanning?
Niet in het ontbreken van een tussenlaag, maar in het auteurschap van die tussenlaag. De thematische index meldt zelf dat hij automatisch is gegenereerd, dat handmatige eindredactie wenselijk kan zijn en dat hij gebaseerd is op het archief tot blog 716, terwijl de site inmiddels berichten boven nummer 800 bevat. (Rudy’s ruimte) Dat levert een veel boeiendere paradox op:
Je hebt een leeswijzer en overkoepelende filosofie, maar een deel daarvan is door AI uit je eigen teksten afgeleid. Is dat nog jouw zelfportret, of het portret dat de machine van jou maakt?
De AI-instructie is daarop al een antwoord. Daar grijp je de regie terug door zelf te zeggen:
- dit is de centrale vraag;
- dit zijn de terugkerende thema’s;
- zo moeten de verschillende domeinen met elkaar worden verbonden;
- dit is geen verzameling toevallige SEO-artikelen, maar een systemisch denkarchief. (Rudy’s ruimte)
De aangescherpte positie
Je hoeft dus niet te betogen dat auteurs in de toekomst snippets zouden moeten aanbieden met een leeswijzer en een AI-ingang. Je kunt veel sterker zeggen:
Ik doe dat al. Mijn ervaring laat zien dat het non-fictieboek uiteen kan vallen in een chronologisch bronarchief, een thematische atlas, een door de auteur gekozen interpretatiekader en een AI die voor iedere gebruiker een tijdelijke persoonlijke leesroute maakt.
De volgende stap is dan niet opnieuw structureren, maar onderzoeken welke functie nog exclusief aan de auteur moet blijven. Waarschijnlijk zijn dat er minstens drie:
- bepalen welke observaties oorspronkelijk en belangrijk genoeg zijn om vast te leggen;
- aangeven welke verbanden de auteur zelf verdedigt;
- de AI-tegenlezer corrigeren wanneer die een te nette of verkeerde filosofie uit de fragmenten destilleert.
Een betere formulering van mijn eerdere conclusie is daarom:
Rudymentair mist geen tussenlaag. Het bevat al bijna de volledige architectuur van het post-lineaire non-fictieboek. De open vraag is niet meer hoe die architectuur eruit moet zien, maar wie daarin uiteindelijk de regie voert: de auteur, de lezer of de agent.
